[Agent Memory / 强化学习] MemPO源码学习笔记 --- (3)--- Rollout思路
[Agent Memory / 强化学习] MemPO源码学习笔记 --- (3)--- Rollout思路
0x00 概要
现有的基于强化学习的 Memory 管理方法往往缺乏一种有效机制针对 Memory 的更新内容进行引导优化,Memory 的内容难以保证质量。
MemPO(Self-Memory Policy Optimization)使模型对 Memory 进行自管理,并引入了基于有效信息含量的 Memory-level 的优势估计,引导 Memory 保留对解决任务更有效的信息,进而提升记忆有效性。
MemPO的独特切入点:让模型把记忆写在每轮开头(
MemPO 的信息如下:
-
论文标题:MemPO: Self-Memory Policy Optimization for Long-Horizon Agents
-
模型和数据集地址:https://huggingface.co/collections/NewBeeKing/mempo
本篇看一些rollout的设计思路。
0x01 Rollout 主要内容
1.1 时间线
MemPO 的时间线如下,可以看到Rollout的阶段:
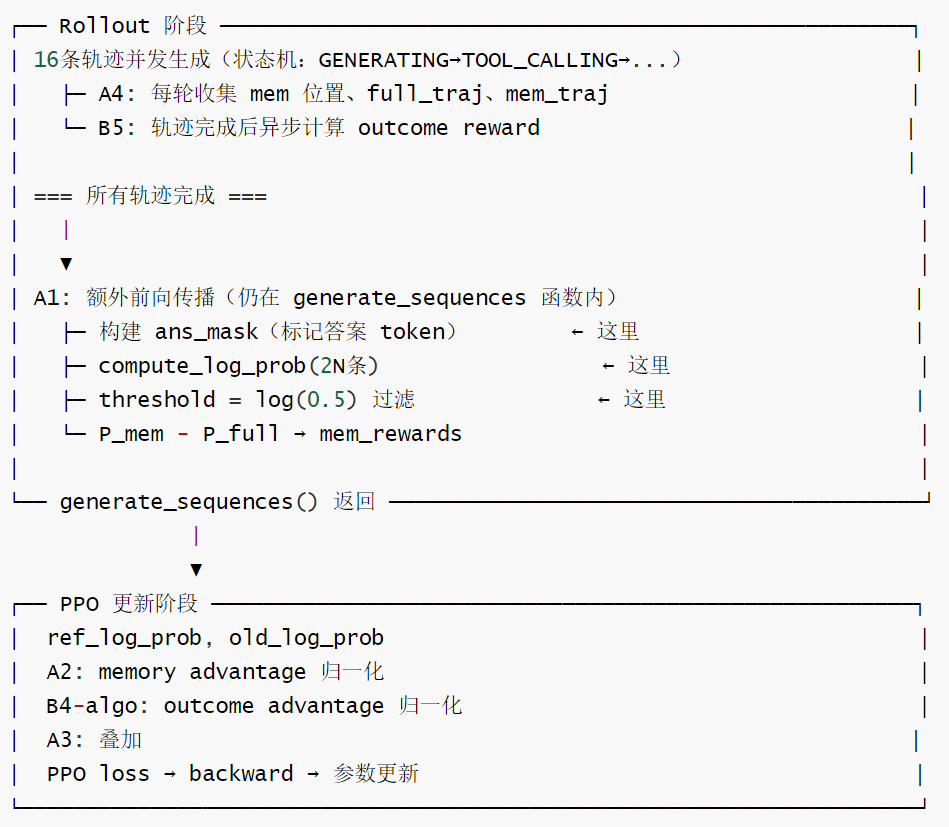
1.2 纯 Rollout
Rollout 阶段
纯 Rollout = 生成轨迹 + 收集数据的过程,即 AgentLoopManager.generate_sequences() 函数的主体部分:
纯 Rollout 阶段(生成 token + 工具交互): B6 AgentLoopManager.generate_sequences ← 调度器,启动16条并发 A4 _handle_generating_state ← 每轮生成后收集位置和内容 C3 ToolParser.parse ← 解析 /标签 C4 AsearcherSearchTool.execute ← 调用 RAG 检索 B5 RewardManagerWorker.compute_score ← 轨迹完成后异步触发(与rollout并行) └→ B1 NaiveRewardManager.__call__ ← 解码+调用评分 └→ B2 compute_score ← 主评分入口 ├→ C2 extract_solution ← 提取 ├→ B3 validate_format ← 格式校验 └→ B4 em_check ← 精确匹配
Rollout 后处理(仍在同一函数内,但所有轨迹已完成):
A1 _postprocess ← 额外前向,计算 P_mem-P_full
不属于 Rollout 阶段
MemPO 有些内容是混合在一起的。比如:ans_mask 和 threshold 属于 rollout 阶段的尾部——在 AgentLoopManager.generate_sequences() 函数内,所有 16 条轨迹 rollout 完成后执行的额外前向传播。
但实际上,ans_mask 和 threshold 既不在"纯 rollout"阶段(生成 token),也不在"纯 reward"阶段(B 系列 em_check),而是在 rollout 完成后的 Memory Reward 计算阶段(A1)——它仍在 rollout 函数内部,但逻辑上属于 memory reward 计算。
  B4-algo   compute_grpo_outcome_advantage             ← PPO 更新前的 advantage 归一化
  A2        compute_grpo_memory_advantage              ← PPO 更新前的 advantage 归一化
  A3        compute_advantage                          ← 叠加
  A5        AgentMemory.prepare_prompt                 ← 评估专用,训练不调用
因此,我们本篇不仅仅会介绍 纯 rollout 阶段,也会介绍 ans_mask 和 threshold 这些“跨界"的内容。
1.3 batch计算
advantage 是对 batch 中的每条轨迹都计算的。
关键点:归一化是按 question 分组的(同组16条轨迹互相比较),不是全 batch 统一归一化。这确保了不同难度的 question 之间不会互相干扰 ✅
一个 batch(假设3个question × 16条轨迹/question = 48条):
    Question Q1:  traj_1, traj_2, ..., traj_16
    Question Q2:  traj_17, traj_18, ..., traj_32
    Question Q3:  traj_33, traj_34, ..., traj_48

Outcome Advantage:
  Q1 组:scores = [1,0,1,1,0,...] → mean=0.6, std=0.5
        adv_1 = (1-0.6)/0.5 = +0.8
        adv_2 = (0-0.6)/0.5 = -1.2
        ...
  Q2 组:独立计算 mean/std
  Q3 组:独立计算 mean/std

  → outcome_adv [48, seq_len]  每条轨迹一个值,广播到其所有token

Memory Advantage:
  Q1 组:所有16条轨迹的所有轮次 mem_reward 池化(~48个值)
        → 统一 mean/std
        → 每条轨迹的每轮  区间各自赋值

  → mem_adv [48, seq_len]  每条轨迹的  区间各有不同值

最终:
  final_adv [48, seq_len] = outcome_adv + mem_adv
  → 每条轨迹、每个 token 位置都有一个确定的 advantage 值
  → 全部送入 PPO loss 一起更新
1.4 前向传播
在前向传播(生成阶段的常规采样)之外,MemPO 还有一次前向传播(extra forward pass),其实就是Teacher Scoring。Teacher Scoring的特殊之处在于:
- 这个compute_log_prob调用是detached的(不参与PPO的反向传播)。它仅用于计算mem_reward数值,作为常数系数进入 advantage。
- extra forward pass 做的是:对“已经生成好的答案“重新算概率,不是重新生成,P_mem和P_full的计算过程 不是“完整推理",是“计算给定文本的概率"
- 推理(Inference) = 模型自己生成新token(自回归解码)
- 前向传播(Forward Pass) = 给定已有文本,计算每个token 的概率
实际做法
compute_log_prob 在 A1 中通过一次调用同时处理 2N 条输入一但实际上是一次前向传播(batch 推理),不是两次独立的前向。
- 合并方案(实际使用):1次前向,batch=2N→高GPU利用率
- 拆分方案(没采用):2次前向,各batch=N→两倍调用开销,且无法复用KVcache
A1的做法如下:
1.训练rollout阶段:模型已经生成了轨迹(包含
2.准备两种“输入上下文":
- full_traj(完整轨迹):系统提示+原始问题+第1轮对话+搜索结果 + 第2轮对话 + 搜索结果 + ···第T轮所有上下文
- mem_traj(仅记忆上下文):系统提示+
第T轮记忆内容
3.把"正确答案Z"接在后面,让模型计算概率:
P_full = P(Z| full_traj)
P_mem = P(Z| mem_traj)
具体如下
# 把full_traj 和 mem_traj拼成一个大 batch
traj_input.input_ids = pad([
    full_1, full_2, ..., full_N,     ←    N条完整上下文
    mem_1,mem_2,..., mem_N,          ←    N条仅含摘要
J)

#answer 重复两遍
traj_input.responses =[ans_1,...,ans_N, ans_1,...,ans_N]

#一次前向传播(batch size=2N),同时算两种上下文的 logp
log_probs = model.compute_log_prob(traj_input)

#拆分结果
full_logp = log_probs[:N]      # ←前半:完整上下文→答案的 log 概率
mem_logp = log_probs[N:2N]     # ←后半:mem 摘要→答案的 log 概率

# 关键:这是一次batch前向传播,GPU同时处理2N条序列。之所以这样做而不是分两次调用:
图示
rollout生成的轨迹(已完成):
Q -> [mem1][think][search] ──► 结果 ──► [mem2][think][answer Z]
MemPO 额外做的事 (不生成新内容,只算概率):
情况 A:给完整上下文,答案 Z 的概率是多少?
┌───────────────────────────┐    ┌─┐
│Q + 完整对话历史 (full_traj) │ ──►│Z│ P_full = 0.72
└───────────────────────────┘    └─┘
情况 B:只给
┌────────────────────────────────┐    ┌─┐
│sys_prompt + 记忆内容 │──► │Z│ P_mem=0.68
└────────────────────────────────┘    └─┘
mem_reward = P_mem - P_full = 0.68 - 0.72 = -0.04 ──►记忆写得不够好,单靠记忆比看完整上下文差 4% ──►对
1.5 Rollout 生成轨迹
Rollout只生成一种轨迹一一一完整的多轮对话轨迹。full_traj和mem_traj是从这条轨迹中提取/构造出来的。
Rollout阶段实际发生的事:
B6:同一个 question 发给 SGLang 16次
→ 16条独立的并发轨迹(每条走状态机GENERATING>TOOL_CALLING>...)
→ 因为LLM采样有随机性(temperature),16条轨迹内容各不相同
单条轨迹的生成过程(多轮示例):
Round 1:LLM生成 → .:....query → 工具返回结果
Round 2:LLM生成 → ......query → 工具返回结果
Round 3:LLM生成 → :.....xxx → 结束
这就是唯一生成的"轨迹"→response_ids
A4在每轮生成后"顺便"提取:
Round 2生成后:
full_traj[0]=deepcopy(raw_input_ids) ← 当时的完整上下文快照
mem_traj[0]=mem_sys_prompt_ids + "R2摘要 " ← 手工拼接
Round 3生成后:
full_traj[1]=deepcopy(raw_input_ids) ← 更长的完整上下文
mem_traj[1]=mem_sys_prompt_ids + "R3摘要 " ← 手工拼接
关键区分:
- 生成的轨迹:只有一种(16条完整对话轨迹,由LLM实际生成token)
- 提取/构造的数据:full_traj是上下文快照,mem_traj是人工拼接的短序列
- full_traj和mem_traj不是通过LLM生成的,而是从已有数据中截取/拼接的
0x02 full_traj的构建方式
2.1 快照
快照
full_traj不是整条轨迹,而是某一轮开始生成前的"上下文快照"。
假设一条5轮轨迹:
    Round 1:[system + question]                                    → R1 response
    Round 2:[system + question + R1 + tool_result_1]               → R2 response
    Round 3:[system + question + R1 + tool_result_1 + R2+ tool_2]  → R3 response
    Round 4:[...更长]                                              → R4 response
    Round 5: [...最长]                                              → R5 (answer)

full_traj_list收集的是(仅Round 2+且有的轮次):
	full_traj[0] = [system + question + R1+ tool_result_1]                → R2前的上下文
	full_traj[1] = [system + question + R1 + tool_1+R2+ tool_2]           → R3前的上下文
	full_traj[2] = [system + question + R1 + tool_1+R2+tool_2+R3+tool_3]  → R4前的上下文
    ↑ 每个都是当轮生成前的完整prompt(deepcopy(raw_input_ids))
    ↑ 不包含当轮生成的response
所以full_traj="到当前轮为止的完整对话历史(不含当轮输出)",用于回答:"如果模型看到了到目前为止的所有对话,它能预测正确答案的概率是多少?"。对比下,mem_traj="只看system+question + 当轮
对比
其实,full_traj 这个名字容易误导一full_traj 的"full"不是指"完整的最终轨迹",而是指"那一轮的完整上下文"(相对于mem_traj只有question +
最终的轨迹(rollout产出的真正轨迹):
	= prompt_ids + response_ids
	= [system + question]+[R1 + tool_1 + R2+ tool_2+ R3 +..+ R5_answer]
	← 包含所有轮次的完整对话,是PPO Update使用的数据

full_traj[k](A4收集的):
	= 第k+2轮生成前的上下文快照
	← 不是最终轨迹,是中间的"截面"
	← 仅用于A1 Memory Reward计算
	← 不用于PPO Update
最终的轨迹与full_traj的关系如下:
最终轨迹(response_ids):
	[R1_tokens | R2_tokens | R3_tokens | R4_tokens |.R5_tokens] ← 这是PPO训练的对象

full_traj[]:
    full_traj[0]= 到R2开始前的上下文 ← 是最终轨迹的"前缀截取"
    full_traj[1]= 到R3开始前的上下文 ← 更长的前缀
    full_traj[2]= 到R4开始前的上下文 ← 更长的前缀
     ← 仅用于MemoryReward的概率对比
计算
假如最终轨迹是5轮,我们并不会对5轮全部计算,而是"有
5轮轨迹的典型情况:
┌─────────┬─────────────────────────┬────────────────────────────────────┐
│ Round 1 │ 第一轮,没有历史          │ → 不产生  → ✗ 不计算            │
│ Round 2 │ 有                 │ → ☑ 计算 mem_reward_R2             │
│ Round 3 │ 有                 │ → ☑ 计算 mem_reward_R3             │
│ Round 4 │ 有                 │ → ☑ 计算 mem_reward_R4             │
│ Round 5 │ 最后一轮给 answer        │ → 可能有也可能没有               │
│         │                        │   如果有 → ☑ 计算;如果没有 → ✗ 不计算 │
└─────────┴────────────────────────┴─────────────────────────────────────┘
流程如下:
A1: 对有的3-4轮各计算mem_reward
A2:所有mem_reward跨轨迹跨轮次池化→归一化
A3:归一化后的mem_adv写入final_adv的对应...<\/mem>区间

final_adv [seq_len]:
    [R1 tokens   | R2 | other R2 | R3 | other R3 | ...]
    [outcome_adv | outcome+adv_2 | outcome  | outcome+adv_3 | outcome  | ...]
                   ↑ 写入            不写         ↑ 写入            不写
关键规则:
validate_format的规则8强制每轮都写
2.2 使用
所有full_traj都会被用上一在A1(Memory Reward计算)中全部使用。注意:full_traj仅用于Memory Reward计算(A1),不用于Outcome Reward(B系列),也不用于PPO Update的actor前向。PPO Update 用的是 rollout 产出的原始response_ids。
假设 batch=3 个 question × 16 条轨迹/question=48 条轨迹,每条轨迹有3轮产生
A1的输入:
    concat_fu1l=48条轨迹×3轮=144个full_traj (全部拍平)
    concat_mem=48条轨迹×3轮=144个mem_traj   (全部拍平)
    → 拼成 2×144=288 条 → 1 次 compute_log_prob 前向
    → 得到 144 个 P_full 和 144 个 P_mem
    → 144个 mem_reward = P_mem - P_full

重组回轨迹:
	轨迹1的mem_rewards = [r_R2, r_R3, r_R4]
	轨迹2的mem_rewards = [r_R2, r_R3]
	...
    → 全部用于A2的advantage 归一化
    → 最终影响 PPO loss 中  token 的梯度方向
A1计算时,每个full_traj[k]都会产出一个mem_reward:
full_traj[0] + answer → P_full_R2 ─┐
mem_traj[0]  + answer → P_mem_R2  ─┤→ mem_reward_R2 = P_mem_R2 - P_full_R2

full_traj[1] + answer → P_full_R3 ─┐
mem_traj[1]  + answer → P_mem_R3  ─┤→ mem_reward_R3 = P_mem_R3 - P_full_R3

full_traj[2] + answer → P_full_R4 ─┐
mem_traj[2]  + answer → P_mem_R4  ─┤→ mem_reward_R4 = P_mem_R4 - P_full_R4

→ mem_rewards = [mem_reward_R2, mem_reward_R3, mem_reward_R4]
→ 3 个值全部进入 A2 归一化

A2 归一化后写入 final_adv 的不同区间:
    final_adv: [R1_tokens | R2 tokens | ... | R4 tokens | R5]
                0              mem_adv_R2          ...     mem_adv_R4            0
每个full_traj[k]对应一轮的
0x03 mem_traj的构建方式
构建过程(A4阶段收集)如下:
假设第3轮生成了: "之前搜索发现HurtLocker获得2010最佳影片 现在搜导演... .."
mem_traj构建
mem_traj_ids = mem_sys_prompt_ids + response_mem_ids
↑ ↑
system prompt + 原始question response截取到为止
具体拼接:
[system: "You are a helpful assistant."]
[user: "Who directed the 2010 Best Picture winner?"]
[assistant:"之前搜索发现HurtLocker获得2010最佳影片 "]
↑截断,后面的think/search 全丢弃
对比 full_traj:
[system + question + Round1完整对话 + Round2完整对话 + Round3开头...]
↑ 完整的多轮历史上下文(非常长)
有mask吗?有ans_mask,但不是对 mem_traj 本身做 mask,而是对答案 token 做 mask:
answer_ids = tokenize("\n...\n \n\nKathryn Bigelow\n ") ans_mask: [0,0,0,0,1,1,1,1,1,1,1,1, 0,0, 0, 0]
↑Kathryn Bigelow 的token ↑\n的4个token
含义:只关注"核心答案内容"的 log_prob,忽略/ 标签token
还有一层threshold 过滤mask,其含义:忽略模型"完全没把握"的token
- 某些token无论给什么上下文都预测不好(如人名的中间子词)
- 过滤掉它们,只看模型有信心的token
- 这样 P_mem-P_full 比较更稳定
full_ans_mask = ans_mask AND (full_logp > log(0.5))
mem_ans_mask = ans_mask AND (mem_logp > log(0.5))
完整图示如下:
mem_traj(输入):[sys_prompt| question|摘要 ] ← 无mask
full_traj(输入):·[sys_prompt|question|全部多轮历史...] ← 无mask
answer(目标):[\n...\n\n{gt}\n ]
model.compute_log_prob(input, answer): → log_prob[2N,ans_len]←每个答案token 的条件概率
过滤:ans_mask x (logp > threshold)
→ 只保留核心答案 token 中置信度高的部分
→ P = exp(mean(filtered_logp))
我们接下来逐步来看。
0x04 记忆压缩机制
本小节主要是AgentMemory·prepare_prompt()记忆压缩机制深度分析。
4.1 核心逻辑
    def prepare_prompt(self):
        # 1. 固定保留:系统提示+原始问题
        prompt = [{"role": "system", "content": "You are a helpful assistant."}]
        # 原始问题永不丢失
        prompt.append({"role": "user", "content": self.memory[0].text})  # initial prompt
        # 2. 从未尾向前扫描,找"截断点 i flag = 0
        flag = 0

        for i in range(-1, -len(self.memory)-1, -1):
            r = self.memory[i]
            if r.type == "prompt": #到头了
                flag = 2
            elif r.type in ["search_results", "webpage"]: # 每遇到一个工具结果+1
                flag += 1
            elif r.type == "llm_gen": #跳过llm生成
                continue
            else:
                raise RuntimeError(f"Unknown record type: {r.type}")
            if flag == 2: #第二个工具结果→截断
                break
        for j in range(i + 1, 0): # 3. 只保留截断点之后的内容
            r = self.memory[j]
            if r.type in ["search_results", "webpage"]: # 工具结果用摘要
                prompt.append({"role": "user", "content": r.short_text})
            elif r.type == "llm_gen": #llm生成用全文
                prompt.append({"role": "assistant", "content": "" + r.text})
            else:
                raise RuntimeError(f"Unknown record type: {r.type}")
        return prompt
4.2 具体案例
4 轮对话 memory数组内容:
[0] prompt = "原始问题"
[1] llm_gen_1 = "记忆1 ... ... ""
[2] search_1 = "information>搜索结果1(完整,可能很长)"
[3] llm_gen_2 = "记忆2 .."
[4] search_2 = "搜索结果2(完整) "
[5] llm_gen_3 = "记忆3 .."
[6] search_3 = "搜索结果3(完整) " ◄─── short_text = 前100字
[7] llm_gen_4 = "记忆4 ..."
[8] search_4 = "搜索结果4(完整) " ◄─── short_text = 前100字
backward扫描(准备第5轮时):
i=-1:search_4 → flag=1 (不停)
i=-2:llm_gen_4 → skip
i=-3:search_3 → flag=2 ← BREAK! 截断点 =i=-3
forward 拼装 range(-2,0)=[-2,-1]:
memory[-2] = llm_gen_4 → assistant:"记忆4 . "
memory[-1] = search_4 → user:short_text (前100字)
最终送给 LLM的 prompt:
System: You are a helpful assistant.
User: 原始问题
Asst: 记忆4 ... ... <- 只有最近1轮
User: 搜索结果4 (前100字) <- short_text 压缩
Asst: <- 模型继续生成
完全看不到:round1、round2、round3的内容!
4.3 设计意图解析
这是"蜗牛背壳" 式记忆压缩设计。
                "蜗牛背壳" 式记忆压缩设计
────────────────────────────────────────────────────────
Round 1:  [Q] -> [Mem1] -> [search] -> [结果1(全)] -> 生成
Round 2:  [Q] +                        [结果1(短)] -> [Mem2]
                   ↑ 只看到上轮结果摘要,其余全靠 Mem1

Round 3:  [Q] +                        [结果2(短)] -> [Mem3]
                   ↑ 同上,靠 Mem2 携带 Mem1 + round1 的信息

Round T:  [Q] + [llm_gen_{T-1}] + [结果_{T-1}(短)] -> 生成
                   ↑仅露出最近 1 轮,强制模型做 "记忆蒸馏"
机制如下:
| 机制 | 细节 |
|---|---|
| 截断粒度 | 以工具结果为计数单位,第2个工具结果之前全部截断用 |
| 工具结果 | short_text(搜索结果前100字,网页前100字) |
| 模型生成 | 用 full_text + 前缀 |
| 原始问题 | 永远保留(memory[0],不截断) |
| 强制效果 | 每轮模型只能看到:原始问题+上轮记忆+上轮搜索摘要 |
记忆压缩链
记忆压缩链如下图所示。类比: 每一站只能带一张 "总结卡片" 上车,车厢里不存过去的东西。
这就是为什么MemPO必须对
Round1 知识  -->  Mem2  -->  Mem3  -->  ...  -->  Mem_T
                  ↑每轮记忆必须覆盖所有历史,否则信息丢失
short_text的真实含义
short_text的两种情况
# prepare_llm_query():
short_text = job.get("short_text", job["text"])
#                   ↑如果没有 short_text 字段,fallback 到完整 text
具体如下:
| 工具结果类型 | text | short_text |
|---|---|---|
| search_results | 完整搜索结果(5篇×每篇前5000字) | =text(无压缩!) |
| webpage | 完整网页分页(每段25000字) | 前100字(真正压缩) |
结论:
- 搜索结果:short_text 等于完整内容,没有压缩
- 网页内容:short_text 只保留前 10o 字,大幅压缩
截断点的真正含义
截断点不是对"文字内容"的截断,而是对"历史轮次"的截断:假设已进行4轮,准备第5轮:
memory =[
[0] prompt
[1] llm_gen_1 "round1记忆 ... ... "
[2] search_1 topk=5篇完整搜索结果
[3] llm_gen_2 "round2记忆 ..."
[4] search_2 topk=5篇完整搜索结果
[5] llm_gen_3 "round3记忆 ..."
[6] search_3 topk=5篇完整搜索结果
[7] llm_gen_4 "round4记忆 ..."
[8] search_4 topk=5篇完整搜索结果 ← 刚放入
]
backward扫描,数工具结果:
search_4 → flag=1(还没截够)
llm_4→跳过
search_3 → flag=2截断点在这里!
组装prompt,只取截断点之后的内容:
llm_gen_4 + search_4
最终LLM看到的prompt:
System: You are a helpful assistant.

User:   原始问题                                      <- 永远保留

Asst:   round4记忆                        <- 仅最后一轮
        ...
        ...

User:   [round4的完整搜索结果]                         <- short_text(搜索=全文)

Asst:                                           <- 等待模型继续生成
round1、round2、round3→完全消失!
直观理解:不是"压缩文字",而是"扔掉历史":
Round 1    Round 2    Round 3    Round4    Round5
[llm][搜]  [llm][搜]  [llm][搜]   [llm][搜]    ?
xxx         xxx       xxx        √√√

x = 完全丢弃(不放进prompt)
√ = 放进prompt(搜索结果用short_text,llm 输出前缀)
模型要从round4的
4.4 设计一致性验证
我们来看看 mem_reward与prepare_prompt()是否相互印证?
确认假设
先确认两者各自的"假设"。
prepare_prompt()在推理时展示给模型:
- sys_prompt
- 原始问题(memory[0])
- 上一轮llm 输出(记忆 ...
- 上一轮搜索结果(short_text)
mem_traj(训练时用来算P_mem)
mem_sys_prompt_ids = deepcopy(prompt_ids) + response_mem_ids(当前轮... 内容)
# prompt_ids = 完整的初始prompt,包含系统提示 + 原始问题(这是rollout开始时的 input)
两者的对比
                prepare_prompt()(推理)       mem_traj(训练信号)
─────────────────────────────────────────────────────────────────────────────
系统提示         √包含                         包含(prompt_ids的一部分)
原始问题         √包含                         包含(prompt_ids的一部分)
当前轮      √包含(上一轮的记忆)             包含(当前轮的记忆)
上一轮搜索结果    √包含(short_text)             X不包含
历史对话         X不包含(窗口截断)               X不包含
结论:大体一致,有一个关键差异:
- 一致的地方(核心逻辑对齐):两者都强调:"只凭
+原始问题"就应该能回答 → mem_reward 训练目标 = 推理时的实际约束 √ - 差异之处:prepare_prompt()还会展示"上一轮搜索结果的 short_text"(100字),而 mem_traj 不包含这个 short_text
影响:
P_mem的计算条件比 推理时实际条件更严苛(推理时还能看到 100 字搜索摘要,训练奖励却假设只能看记忆)

-> 这意味着训练信号实际上是"高标准版"
-> 如果模型的  通过了这个高标准,推理时(还能看到搜索摘要)
   表现应该更好
设计一致性验证图
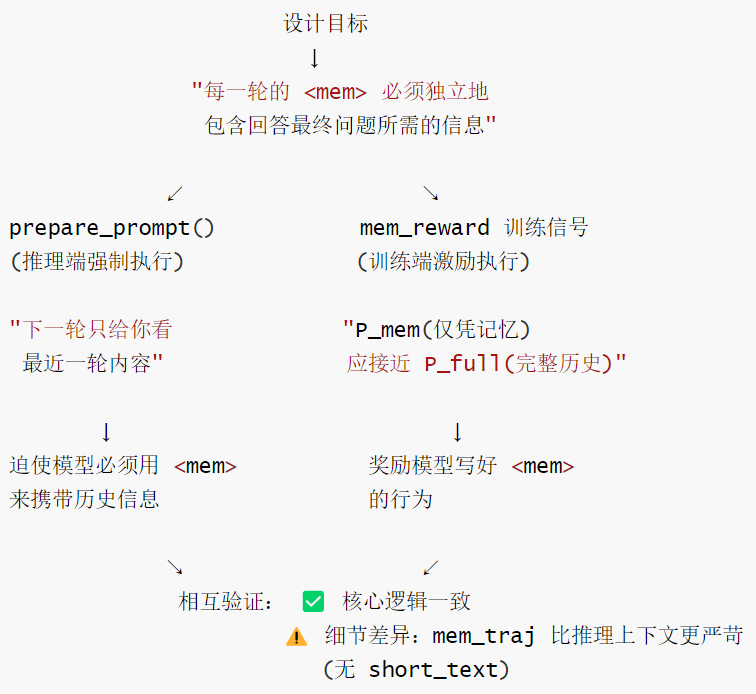
一句话总结:两者确实相互印证—prepare_prompt()是"约束",mem_reward 是"激励",都指向同一个设计目标:让
0x05 潜在问题分析
我们接下来进行潜在问题分析,即目前这种设计会导致模型遗忘什么?
5.1 核心信息流模型
每一轮,模型看到的 prompt:
原始问题(永久保留) + 上轮的(上一轮llm输出的完整文本) + 上轮搜索结果(full text或100字)
那么:
5.2 问题1:空间有限,写不完所有历史
- 训练配置:max_response_length = 4096 tokens(run_train.sh 有效配置)
- 评估配置:模型最大输出(无硬限制,但受模型ctx限制)
一轮 llm 输出 =+ +
如果
5轮对话积累的知识要压缩进一个:
    Round1发现:A是某公司创始人(需记)
    Round2发现:A公司成立于1998年(需记)
    Round3发现:1998年某行业政策(相关背景,是否记?)
    Round4发现:竞争对手信息(是否记?)
	→ 5轮知识 → 500 token,必须选择性遗忘
遗忘什么:模型倾向于丢弃"看起来不重要"的中间事实,但这些事实在后续推理中可能关键。
5.3 问题2:写的是上轮全文,不是摘要
# prepare_prompt() prompt.append({"role":"assistant","content":"" + r.text}) # ↑全文! # r.text = 上轮完整 llm 输出,包括 , 等标签 上轮llm输出(r.text)结构:第4轮记忆摘要 这次搜索到了xxX,结合之前的YYY... 查询词 本轮prompt中看到的:+ 上述全文 = 第4轮记忆摘要 ... . 模型需要从嵌套的...结构中提取信息
潜在遗忘:嵌套结构增加了信息提取难度,模型可能只关注最外层
5.4 问题 3:多跳推理链断裂
典型多跳问题:
Q:"X的创始人在哪所大学取得博士学位?"
Round 1:搜索"X公司"→发现创始人是John
Round 2:搜索"John 教育背景"→发现 John 在 MIT 读博
Round 3:准备回答,应包含:(a)X的创始人=John(round1发现)  (b)John 在MIT(round2发现)

但 round 1 的搜索结果在 round 3 已经丢失!
遗忘什么:推理链条的中间节点。如果模型在某轮没有将发现写入
概率性遗忘分析:
- 每轮都要压缩历史 → 累计遗忘率随轮数指数增加
- 8轮(训练) VS 64轮(评估)→ 评估时遗忘风险远高于训练!
5.5 问题4:训练8轮 vs 评估64轮的分布漂移
-
训练:max_assistant_turns =8(run_train.sh 有效配置),在8轮内,
需"接力"7次 -
评估:max_turns=64,在64轮内,
需"接力"63次
模型从未见过63次接力的样本 → 深层记忆失效
这类似于:训练时打5关的游戏,测试时要打64关 → 后期技能完全没有训练信号
5.6 问题 5:搜索结果 short_text 的非对称设计
search_results.short_text = full_text # 搜索:全文 (可能很长)
webpage.short_text = page[:100] # 网页:仅前100字
对于webpage类型,我们进行分析如下:
当前轮:prompt包含网页全文(25000字)
下一轮:prompt中这个网页只有100字(截断99.6%!)
100字约等于3~4句话→极度压缩
网页中的关键段落(位于第3段)→ 完全消失
这要求,模型在上轮必须把关键内容写进
5.7 汇总:信息遗忘风险矩阵
| 信息类型 | 遗忘概率 | 原因 |
|---|---|---|
| 早轮搜索结果的细节 | 高 | 完全从prompt中删除 |
| 网页内容的非开头部分 | 极高 | short_text 仅保留前 100 字 |
| 中间推理链的中间节点 | 中-高 | 模型选择性压缩 |
| 原始问题的原文 | 零 | 永远保留在memory[0] |
| 上一轮 |
零 | 直接放入prompt |
| 数值精度(人名、日期等) | 中 |
5.8 MemPO如何缓解(但不能完全解决)
MemPO奖励信号:mem_reward = P_mem(正确答案 I 仅靠
训练压力:让
局限:
- 奖励只看最终答案,不鼓励中间推理链的完整传递
- 奖励以每轮为粒度,无法捕捉"第2轮记忆影响第5轮推理"的长程依赖
- 训练只有8轮,模型没见过深层遗忘场景
0xFF 参考
原文地址: https://www.cveoy.top/t/topic/qHzX 著作权归作者所有。请勿转载和采集!