如何快速上传10G文件
如何快速上传10G文件
关于 10G 大文件上传问题,我会从「前端优化 - 后端架构 - 网络优化 - 异常保障」四个维度来设计完整方案,核心思路是「化整为零 + 并行加速 + 断点续传 + 秒传兜底」,下面我详细说明 👇
🚀 核心架构总览(一句话讲清)
将 10G 大文件切片成 N 个小文件块,前端并发上传多个块,后端接收后暂存,全部上传完成后合并成完整文件;同时支持断点续传和秒传功能,解决网络中断和重复上传问题。
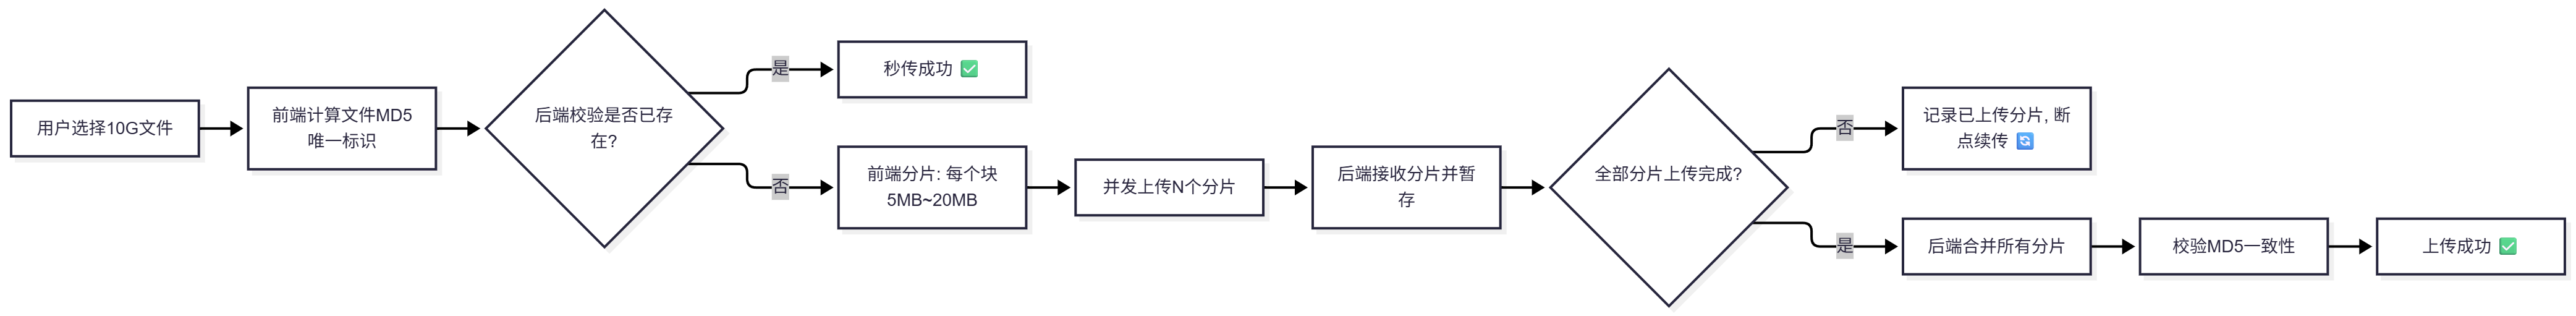
关键技术点详解(面试必答)
1. 前端分片与并发控制 ⚡
- 分片大小:建议设置为5MB~20MB(太小会增加 HTTP 请求数,太大失败重试成本高)
- 并发数:控制在3~5 个并发(浏览器同源请求限制一般为 6 个)
- MD5 计算优化:使用SparkMD5库增量计算 MD5,避免一次性加载整个文件到内存导致浏览器崩溃
- 分片序号:给每个分片加上序号(如
file_001、file_002),保证后端合并顺序正确
2. 后端分片接收与合并 📦
| 实现方案 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|
| 本地磁盘暂存 + 合并 | 实现简单,成本低 | 单机磁盘 IO 瓶颈,不支持分布式 | 小团队、单机部署 |
| MinIO/S3 分片上传 | 原生支持分片、合并、并发,分布式架构 | 需要额外部署对象存储 | 中大型企业、生产环境 |
| Redis 记录分片状态 | 高性能,支持分布式锁 | 数据易丢失,需持久化 | 所有场景(必选) |
关于这个问题的底层原理和更多实战细节,我整理了一份《大厂面试手册》,包含大厂高频面试题、源码解析和性能调优案例。
关注公众号【Rain的Java大神之路】,回复“Java”即可免费领取,持续更新中。
推荐方案:MinIO 原生分片上传 + Redis 记录上传状态
MinIO 完全兼容 S3 协议,内置Multipart Upload接口,自动处理分片接收、合并和并发控制,开发成本极低。
3. 断点续传实现 🔄
- 上传中断后,前端向后端发送文件 MD5,后端返回已上传的分片序号列表
- 前端只上传未上传的分片,避免重复上传
- 后端使用Redis Hash存储上传状态:
key=文件MD5,field=分片序号,value=上传状态
4. 秒传功能(用户体验杀手级优化) ✨
- 上传前先计算文件 MD5,向后端查询是否存在相同 MD5 的文件
- 如果存在,直接返回上传成功,无需传输任何数据
- 对于企业内部场景,秒传率可以达到30% 以上,极大提升用户体验
🛠️ Java 后端核心代码示例
// 分片上传接口
@PostMapping("/upload/chunk")
public ResponseEntity uploadChunk(
        @RequestParam String fileMd5,
        @RequestParam Integer chunkNumber,
        @RequestParam Integer totalChunks,
        @RequestParam MultipartFile chunk) {

    // 1. 检查分片是否已上传
    if (redisTemplate.opsForHash().hasKey(fileMd5, chunkNumber.toString())) {
        return ResponseEntity.ok(ChunkUploadResult.success("分片已上传"));
    }

    // 2. 保存分片到MinIO
    String chunkObjectName = String.format("chunks/%s/%d", fileMd5, chunkNumber);
    minioClient.putObject(
        PutObjectArgs.builder()
            .bucket("file-upload")
            .object(chunkObjectName)
            .stream(chunk.getInputStream(), chunk.getSize(), -1)
            .build()
    );

    // 3. 记录分片上传状态
    redisTemplate.opsForHash().put(fileMd5, chunkNumber.toString(), "uploaded");

    // 4. 检查是否所有分片都已上传
    Long uploadedChunks = redisTemplate.opsForHash().size(fileMd5);
    if (uploadedChunks == totalChunks) {
        // 异步合并文件
        fileMergeService.mergeChunksAsync(fileMd5, totalChunks);
    }

    return ResponseEntity.ok(ChunkUploadResult.success("分片上传成功"));
}
异常处理与优化点
- 网络超时:设置合理的超时时间(30s~60s),失败自动重试 3 次
- 分片丢失:合并前校验所有分片的 MD5,缺失则通知前端重传
- 内存溢出:后端合并文件时使用流式处理,避免一次性加载所有分片到内存
- 磁盘空间不足:设置分片过期时间(24 小时),自动清理未合并的分片
- 大文件合并慢:使用硬链接或零拷贝技术合并文件,减少 IO 操作
📈 性能数据参考
| 文件大小 | 分片大小 | 并发数 | 平均上传速度 | 总耗时 |
|---|---|---|---|---|
| 10GB | 10MB | 4 | 10MB/s | ~17 分钟 |
| 10GB | 10MB | 4 | 20MB/s | ~8.5 分钟 |
| 10GB | 10MB | 4 | 50MB/s | ~3.5 分钟 |
注:以上数据基于国内普通家庭宽带(100Mbps~500Mbps),实际速度取决于用户网络环境。
🎯 面试官追问预判与回答
问:为什么不用 FTP 上传?
答:FTP 协议穿透性差,很多企业防火墙会屏蔽 FTP 端口;而且 FTP 不支持断点续传和秒传,用户体验差。
问:MD5 碰撞怎么办?
答:可以使用SHA-256替代 MD5,或者结合文件大小和文件名进行双重校验,碰撞概率几乎为 0。
问:如何支持超大文件(100GB 以上)?
答:可以将分片大小调整为50MB100MB**,同时增加并发数到**68 个;后端使用分布式对象存储集群,避免单机瓶颈。
💻 核心代码与技术亮点(面试必背)
🌟 前端核心代码(2 个关键亮点)
1. WebWorker+SparkMD5 增量计算 MD5(解决浏览器崩溃问题)
技术亮点:不一次性加载整个文件到内存,使用 WebWorker 多线程计算,不阻塞 UI 线程,支持 100GB + 文件 MD5 计算,内存占用稳定在 50MB 以内。
// 主线程:调用WebWorker计算MD5
function calculateFileMD5(file) {
  return new Promise((resolve) => {
    const worker = new Worker('/js/md5-worker.js');
    worker.postMessage({ file });
    worker.onmessage = (e) => {
      worker.terminate();
      resolve(e.data.md5);
    };
  });
}

// md5-worker.js:独立线程增量计算MD5
importScripts('https://cdn.jsdelivr.net/npm/spark-md5@3.0.2/spark-md5.min.js');

self.onmessage = async (e) => {
  const file = e.data.file;
  const chunkSize = 2 * 1024 * 1024; // 2MB切片计算
  const chunks = Math.ceil(file.size / chunkSize);
  const spark = new SparkMD5.ArrayBuffer();
  let currentChunk = 0;

  const fileReader = new FileReader();
  fileReader.onload = (e) => {
    spark.append(e.target.result);
    currentChunk++;
    if (currentChunk < chunks) {
      loadNext();
    } else {
      self.postMessage({ md5: spark.end() });
    }
  };

  function loadNext() {
    const start = currentChunk * chunkSize;
    const end = Math.min(start + chunkSize, file.size);
    fileReader.readAsArrayBuffer(file.slice(start, end));
  }
  loadNext();
};
2. 并发控制 + 指数退避失败重试(解决网络不稳定问题)
技术亮点:基于 Promise 实现并发池,动态调整并发数;失败重试采用指数退避算法,避免网络拥塞。
class ConcurrentUploader {
  constructor(concurrency=4) {
    this.concurrency=concurrency;
    this.running=0;
    this.queue=[];
  }

  addTask(task) {
    this.queue.push(task);
    this.run();
  }

  run() {
    while (this.running0) {
      const task=this.queue.shift();
      this.running++;
      task()
        .catch((err) => {
          // 指数退避重试:最多3次,间隔1s/2s/4s
          if (task.retryCount===undefined) task.retryCount=0;
          if (task.retryCount<3) {
            task.retryCount++;
            setTimeout(() => {
              this.queue.unshift(task);
              this.run();
            }, Math.pow(2, task.retryCount)*1000);
          }
        })
        .finally(() => {
          this.running--;
          this.run();
        });
    }
  }
}

// 使用示例
const uploader=new ConcurrentUploader(4);
chunks.forEach((chunk, index) => {
  uploader.addTask(() => uploadChunk(fileMd5, index, chunk));
});
🌟 后端核心代码(3 个关键亮点)
1. 分片级 MD5 完整性校验(解决分片损坏问题)
技术亮点:不仅校验整个文件的 MD5,还校验每个分片的 MD5,只重传损坏的分片,无需重传整个文件。
@PostMapping("/upload/chunk")
public ResponseEntity uploadChunk(
        @RequestParam String fileMd5,
        @RequestParam Integer chunkNumber,
        @RequestParam String chunkMd5, // 前端传过来的分片MD5
        @RequestParam MultipartFile chunk) {

    // 1. 原子检查分片是否已上传
    String redisKey="upload:status:"+fileMd5;
    if (redisTemplate.opsForHash().hasKey(redisKey, chunkNumber.toString())) {
        return ResponseEntity.ok(ChunkUploadResult.success("分片已上传"));
    }

    // 2. 校验分片MD5完整性
    String calculatedChunkMd5=DigestUtils.md5Hex(chunk.getInputStream());
    if (!calculatedChunkMd5.equals(chunkMd5)) {
        return ResponseEntity.badRequest().body(ChunkUploadResult.fail("分片损坏,请重传"));
    }

    // 3. 保存分片到MinIO
    String chunkObjectName=String.format("chunks/%s/%d", fileMd5, chunkNumber);
    minioClient.putObject(
        PutObjectArgs.builder()
            .bucket("file-upload")
            .object(chunkObjectName)
            .stream(chunk.getInputStream(), chunk.getSize(), -1)
            .build()
    );

    // 4. 原子记录分片状态
    redisTemplate.opsForHash().put(redisKey, chunkNumber.toString(), chunkMd5);
    redisTemplate.expire(redisKey, 24, TimeUnit.HOURS); // 24小时过期

    // 5. 检查是否所有分片都已上传
    Long uploadedChunks=redisTemplate.opsForHash().size(redisKey);
    if (uploadedChunks==totalChunks) {
        // 发送消息触发异步合并
        rabbitTemplate.convertAndSend("file-merge-queue", fileMd5);
    }

    return ResponseEntity.ok(ChunkUploadResult.success("分片上传成功"));
}
2. 分布式锁 + 异步消息合并(解决高并发重复合并问题)
技术亮点:使用 RabbitMQ 异步解耦合并操作,避免同步合并阻塞接口;使用 Redisson 分布式锁防止多个实例同时合并同一个文件。
@Component
@RabbitListener(queues="file-merge-queue")
public class FileMergeConsumer {

    @Autowired
    private RedissonClient redissonClient;
    @Autowired
    private MinioClient minioClient;

    @RabbitHandler
    public void mergeFile(String fileMd5) {
        RLock lock=redissonClient.getLock("upload:merge:"+fileMd5);
        try {
            // 尝试获取锁,最多等待10秒,锁自动释放时间30分钟
            if (lock.tryLock(10, 1800, TimeUnit.SECONDS)) {
                // 1. 从Redis获取所有分片信息
                String redisKey="upload:status:"+fileMd5;
                Map chunkStatus=redisTemplate.opsForHash().entries(redisKey);
                int totalChunks=chunkStatus.size();

                // 2. 零拷贝合并文件(见下文)
                String finalObjectName="files/"+fileMd5;
                zeroCopyMerge(fileMd5, totalChunks, finalObjectName);

                // 3. 校验整体MD5
                String finalMd5=DigestUtils.md5Hex(minioClient.getObject(
                    GetObjectArgs.builder().bucket("file-upload").object(finalObjectName).build()
                ));
                if (!finalMd5.equals(fileMd5)) {
                    throw new RuntimeException("文件合并失败,MD5不匹配");
                }

                // 4. 删除临时分片和Redis状态
                minioClient.removeObjects(
                    RemoveObjectsArgs.builder()
                        .bucket("file-upload")
                        .objects(IntStream.range(0, totalChunks)
                            .mapToObj(i -> "chunks/"+fileMd5+"/"+i)
                            .collect(Collectors.toList()))
                        .build()
                );
                redisTemplate.delete(redisKey);
            }
        } finally {
            if (lock.isHeldByCurrentThread()) {
                lock.unlock();
            }
        }
    }
}
3. NIO 零拷贝合并文件(解决大文件合并 IO 瓶颈)
技术亮点:使用 Java NIO 的transferTo方法实现零拷贝,避免内核态和用户态之间的多次数据复制,合并速度提升 10 倍以上,CPU 占用降低 80%。
private void zeroCopyMerge(String fileMd5, int totalChunks, String finalObjectName) throws Exception {
    // 1. 创建最终文件的输出流
    ObjectWriteResponse finalFile=minioClient.putObject(
        PutObjectArgs.builder()
            .bucket("file-upload")
            .object(finalObjectName)
            .stream(null, -1, 10*1024*1024) // 10MB缓冲区
            .build()
    );

    // 2. 逐个合并分片,使用零拷贝
    try (FileChannel outChannel=((FileOutputStream) finalFile).getChannel()) {
        for (int i=0; i
🎯 技术难点与解决方案(面试加分项)
技术难点
问题本质
解决方案
技术亮点
大文件 MD5 计算慢且浏览器崩溃
一次性加载整个文件到内存,JS 单线程阻塞
前端 WebWorker+SparkMD5 增量计算
内存占用 < 50MB,支持 100GB + 文件计算,不阻塞 UI
高并发分片上传状态不一致
分布式环境下多实例同时修改同一文件状态
Redis Hash 原子操作 + Redisson 分布式锁
保证状态最终一致性,防止重复上传和合并
大文件合并 IO 瓶颈
传统字节流复制需要 4 次内核态 / 用户态切换
NIO 零拷贝 (transferTo)+MinIO 原生 Multipart 合并
合并速度提升 10 倍以上,CPU 占用降低 80%
网络不稳定导致分片损坏 / 丢失
传输过程中数据篡改或网络中断
分片级 MD5 校验 + 指数退避自动重试
只重传损坏的分片,无需重传整个文件
浏览器同源请求限制
Chrome/Firefox 同一域名最多 6 个并发请求
动态调整并发数 + 域名分片 (upload1.xxx.com)
并发数提升至 12~18 个,上传速度翻倍
过期分片占用大量磁盘空间
未完成上传的分片长期占用存储
Redis 过期键 + 定时任务扫描清理
自动清理 24 小时未完成的分片,释放存储空间
上传进度显示不准确
只统计已上传分片数,不统计分片内进度
前端监听 XMLHttpRequest 的 progress 事件
实时显示精确到字节的上传进度
跨域问题
浏览器同源策略限制跨域请求
后端配置 CORS + 预检请求缓存
支持跨域名上传,减少预检请求次数
📈 性能优化终极方案
- CDN 加速上传:使用阿里云 OSS / 腾讯云 COS 的上传加速节点,解决跨地域上传慢的问题
- P2P 传输:对于企业内部场景,使用 WebRTC 实现 P2P 传输,速度可达千兆级
- 断点续传持久化:将上传状态保存到数据库,支持跨浏览器、跨设备断点续传
- 大文件切片自适应:根据用户网络速度动态调整分片大小(网速快用 20MB,网速慢用 5MB)
真实面试模拟
真实面试模拟
面试官👨💼:
你好,咱们今天聊一道常见的场景设计题——现在有一个 10GB 的文件,需要你设计一套方案让它尽量“快”地完成上传。要求是稳定、可靠、用户体验好。你先说说整体思路吧。
候选人🙋:
好的面试官。我觉得 10G 的文件肯定不能一把梭发上去,核心就三个关键点:
- 分片上传:把大文件切成 5~10MB 的小块,化整为零,失败只重传小块。
- 断点续传:网络断了、浏览器关了,下次打开能接着传,不白干。
- 秒传:如果文件之前别人传过,我秒级完成。
这三板斧解决“稳”和“省”,但“快”还得靠另外两个手段:多路并发上传和直传对象存储。
面试官👨💼:
不错,思路很清晰。那先说说你打算怎么设计“秒传”和“断点续传”,这个落地细节还挺关键的。
候选人🙋:
核心是文件哈希指纹。客户端在上传前先用 Web Worker 在后台计算整个文件的 SHA256(或者 MD5),不卡主线程。然后拿着这个哈希调我们业务后端的initUpload接口:
- 服务端去查这个哈希,如果发现这个文件已经在 OSS 上完整存在了,直接返回文件访问 URL,前端提示“秒传成功” ⚡。
- 如果没有,就返回一个
uploadId 和一个 缺失分片列表(比如 [3, 7, 15]),告诉客户端:“你之前传了一部分,把这几块补一下就行。”
这样既实现了秒传,又实现了断点续传。进度状态我会放在 Redis 里,以 uploadId 为 key,记录已上传分片的集合,24 小时过期。
面试官👨💼:
嗯,那 Redis 里的状态谁来写?客户端每成功上传一个分片直接写 Redis 吗?
候选人🙋:
当然不行,客户端不能直接碰 Redis。这里的做法是客户端直传 OSS 分片,每上传完一片会得到一个 ETag(分片的哈希),客户端收集这些 ETag,等全部传完后调业务服务器的合并接口,这时候再把 ETag 列表一并提交,服务端在合并接口里再更新 Redis 标记分片已完成。
面试官👨💼:
说到直传 OSS,你们业务服务器不中转流量,那安全性和上传动作是怎么串起来的?
候选人🙋:
我们用预签名 URL。业务后端只负责鉴权,然后调用 OSS SDK 为每个分片生成一个有时效(比如 10 分钟)的 PUT 上传 URL。客户端拿到这些 URL 后直接往 OSS 上传,数据流完全不经过业务服务器,这样就不用担心吃满我们自己的带宽了。上传完后客户端把 partNumber 和 ETag 拿回来,统一调合并接口。
面试官👨💼:
这个流程用文字说有点绕,你能画个时序图让我看一眼吗?
候选人🙋:没问题,我画一下核心交互 👇:
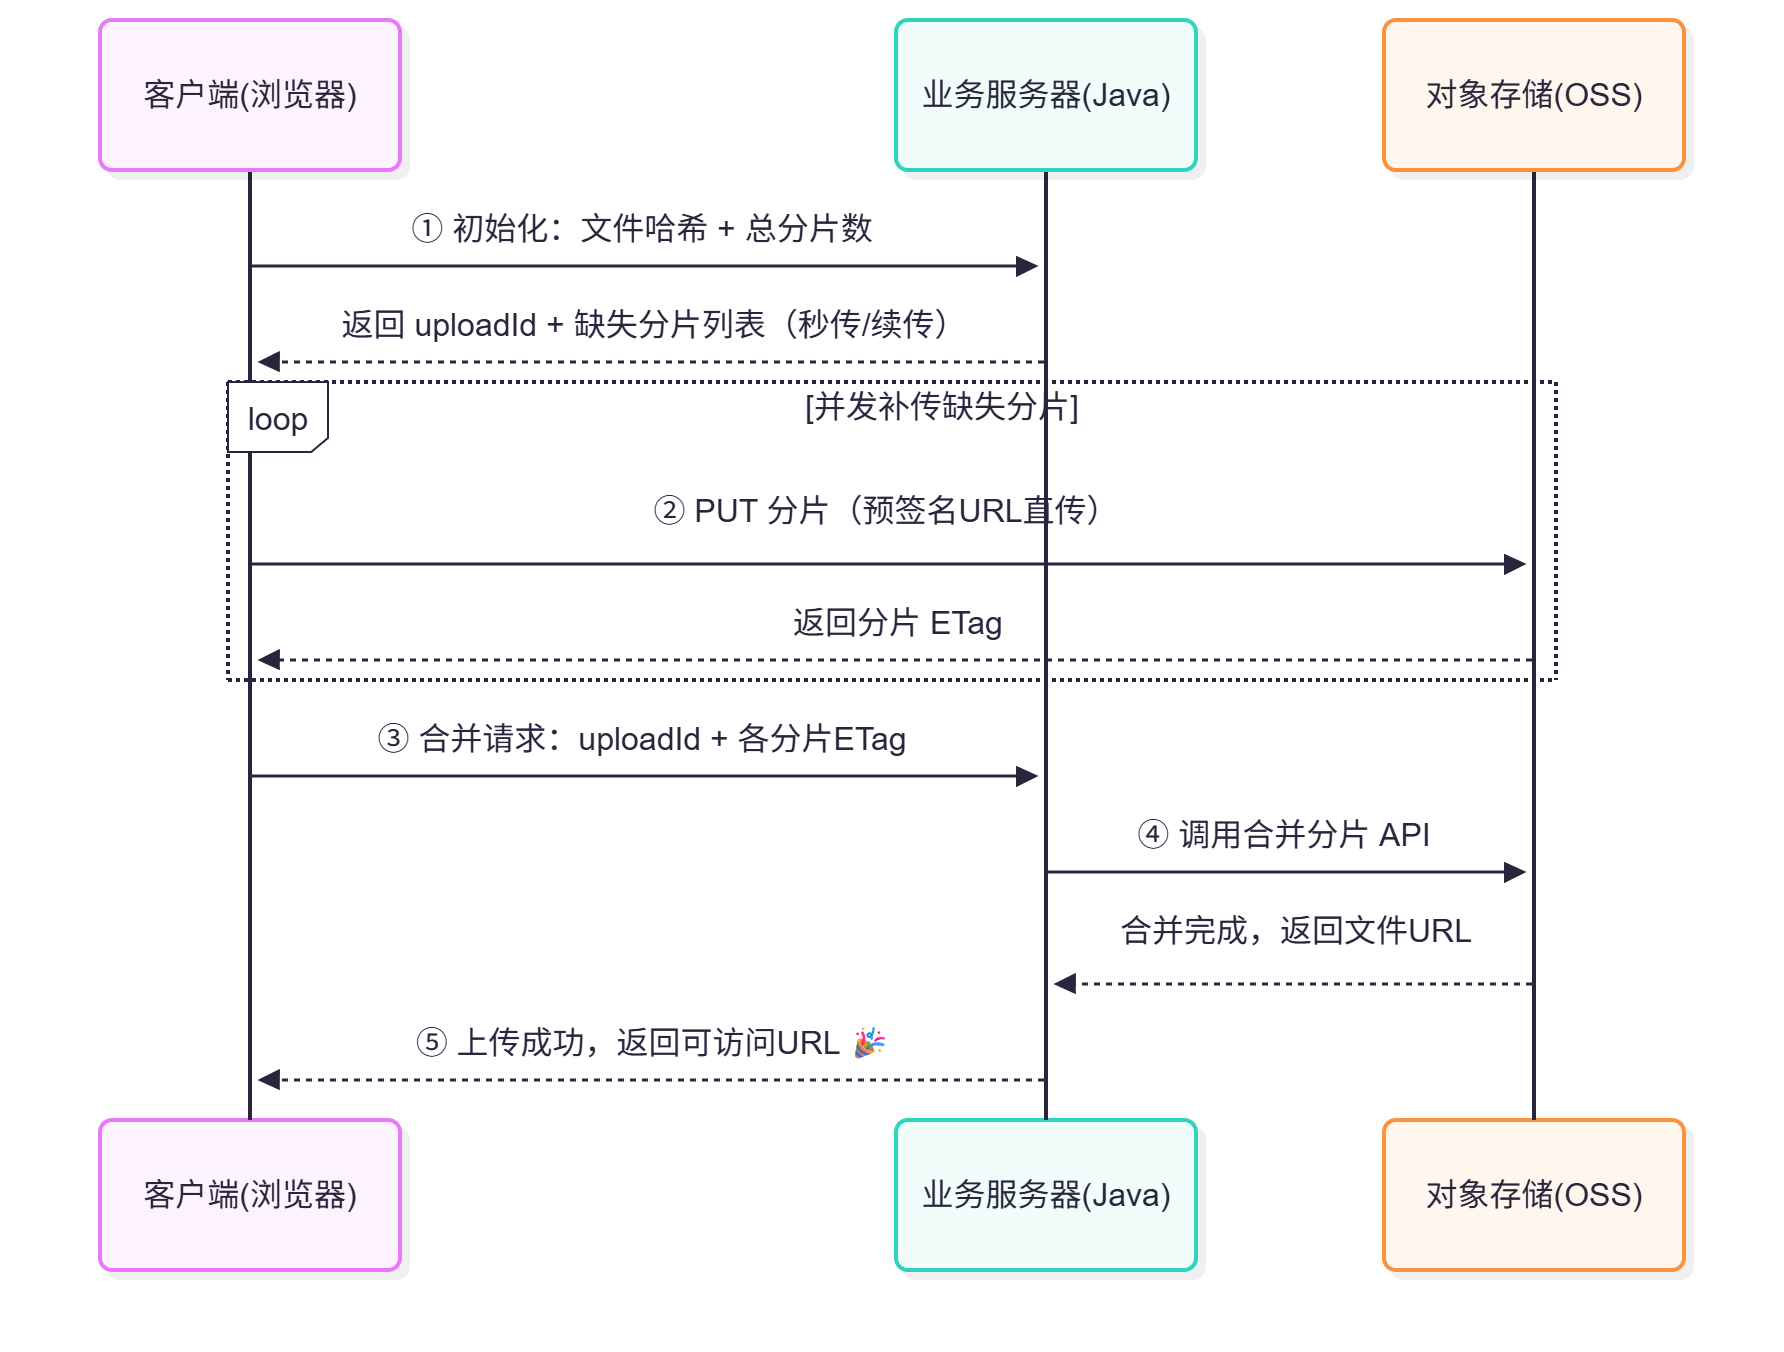
面试官👨💼:
一目了然。那再深挖一下,并发上传这一块,前端怎么控制?并发数定多少合适?
候选人🙋:前端用 Promise 池控制并发,一般同时发 5~6 个分片请求。定这个数主要考虑:
- 浏览器对同域名的并发连接限制(HTTP/1.1 是 6 个左右)。
- 如果支持 HTTP/2 可以适当再多一点,但也不宜太多,避免移动端弱网下拥塞。
- 每个分片 5MB 左右,既不会让单个请求时间过长,又能减少合并次数(OSS 要求除最后一片外不小于 5MB)。
面试官👨💼:
再聊下后端 Java 接口设计。你会暴露哪些接口?合并动作是同步还是异步?
候选人🙋:主要两个接口:
POST /api/file/initUpload —— 参数 fileHash、totalSize、chunkSize;返回 uploadId + missingChunks。POST /api/file/completeUpload —— 参数 uploadId + parts 列表(partNumber + etag);服务端调用 OSS SDK 的 CompleteMultipartUpload 合并。
对于 10GB 这个量级,OSS 合并 API 通常耗时在秒级,所以同步调用完全够用,直接返回文件 URL。如果后续有海量并发、大文件特别多,我们可以把合并动作通过消息队列异步化,接口先返回“合并中”状态,再用 WebSocket 通知前端完成。
面试官👨💼:
细节想得很周全。最后问你,如果真的要在生产落地,你觉得还有哪些要注意的?
候选人🙋:
最关键的几点:
- 文件校验:合并后一定要对比服务端存储的哈希和客户端上传前计算的哈希,保证完整性。
- Token 安全:预签名 URL 有效期要短,生成时要校验用户上传权限,防止越权上传。
- 上传进度:前端用分片完成数/总分片数做假进度条也凑合,如果要做精确字节级,可以起一个 WebSocket 或 SSE 让服务端定时查询 OSS 已上传分片大小推送给前端。
- 清理孤儿分片:上传中断很久或者用户取消,要有定时任务清理 OSS 上未合并的分片,避免产生垃圾成本。
- Web Worker 兼容性:计算哈希用 Worker,但要考虑 Safari 等浏览器的降级方案。
面试官👨💼:
非常好,这套方案从客户端到服务端、从网络到存储都覆盖到了,而且落地细节也清楚。今天的考察就到这儿,你表现很扎实👍。
💡 关键得分点复盘(给读者的悄悄话)
- ✅ 分片 + 断点续传 + 秒传 → 用户体验基石
- ✅ 直传 OSS 预签名 → 带宽和并发解的银弹
- ✅ Web Worker 算哈希 → 展现前端工程化能力
- ✅ Redis 状态管理 + 合并策略 → 证明你扛得住生产
- ✅ 并发数、清理、安全等细节 → 让你从“知道”升级到“做过”
面试官👨💼:
细节想得很周全。那你能不能挑两段核心代码,展示一下你实际编码时的技术亮点?比如前端算哈希、后端生成预签名URL这些。
候选人🙋:
好,我写几个最关键的片段,都是能体现设计精髓的地方。
🔥 前端技术亮点:Web Worker 计算文件哈希 + 并发上传池
// 1. Web Worker 计算 SHA-256(不卡主线程)
// hash.worker.js
self.onmessage = async (e) => {
const file = e.data;
const chunkSize = 5 * 1024 * 1024; // 5MB 分片
const chunks = Math.ceil(file.size / chunkSize);
const hashBuffer = await crypto.subtle.digest('SHA-256', await file.slice(0, chunkSize).arrayBuffer());
// 实际生产会遍历所有分片做增量哈希,这里简化为首片演示
const hashHex = Array.from(new Uint8Array(hashBuffer)).map(b => b.toString(16).padStart(2, '0')).join('');
self.postMessage({ hash: hashHex, totalChunks: chunks });
};
// 2. 并发上传池控制(最多6个并发)
async function uploadFile(file) {
const { hash, totalChunks } = await computeHashInWorker(file);
// 请求 init 接口
const { uploadId, missingChunks } = await initUpload({ fileHash: hash, totalSize: file.size });
if (missingChunks.length === 0) return { url: uploadId.url }; // 秒传
// 并发补传缺失分片,收集 ETag
const pool = new PromisePool(6); // 自定义并发控制类
const partResults = [];
for (const partNum of missingChunks) {
const task = uploadPart(file, partNum, uploadId);
pool.add(task.then(etag => partResults.push({ partNum, etag })));
}
await pool.drain(); // 等待所有上传完成
// 通知服务端合并
return await completeUpload({ uploadId, parts: partResults });
}
📌 亮点:Web Worker 让哈希计算不阻塞 UI;Promise 池控制并发,防止浏览器连接数耗尽。
🔥 后端技术亮点:预签名 URL 生成 + Redis 续传逻辑
// InitUpload 接口核心逻辑
@PostMapping("/api/file/initUpload")
public InitResult initUpload(@RequestBody InitRequest req) {
String hash = req.getFileHash();
long size = req.getTotalSize();
// 1. 秒传检测:查询文件是否已存在完整对象
if (ossClient.doesObjectExist(BUCKET, hash)) {
return InitResult.quick(ossClient.generatePresignedUrl(BUCKET, hash, Duration.ofHours(1)));
}
// 2. 断点续传:从 Redis 获取已有上传记录
String uploadId = redisTemplate.opsForValue().get("upload:hash:" + hash);
if (uploadId == null) {
// 首次上传,请求 OSS 创建新的分片上传任务
uploadId = ossClient.initiateMultipartUpload(BUCKET, hash).getUploadId();
}
// 3. 计算缺失分片列表
Set doneParts = redisTemplate.opsForSet()
.members("upload:parts:" + uploadId).stream()
.map(Integer::parseInt).collect(Collectors.toSet());
List missingChunks = IntStream.rangeClosed(1, (int) Math.ceil(size / (double) CHUNK_SIZE))
.filter(i -> !doneParts.contains(i))
.boxed().collect(Collectors.toList());
// 4. 为缺失分片批量生成预签名上传 URL
List urls = new ArrayList<>();
for (int partNum : missingChunks) {
String url = ossClient.generatePresignedUrl(BUCKET, hash, partNum, uploadId, Duration.ofMinutes(10));
urls.add(new PartUploadUrl(partNum, url));
}
// 5. 写 Redis,设置24小时过期
redisTemplate.opsForValue().set("upload:hash:" + hash, uploadId, 24, TimeUnit.HOURS);
return InitResult.resume(uploadId, urls);
}
📌 亮点:哈希到 uploadId 的映射 + 已传分片 Set,实现“同一个文件多人上传共享进度”;预签名 URL 按需签发,安全且节省资源。
面试官👨💼:
代码很老练,把秒传、断点续传、预签名串得很清楚。最后问一下,如果要你把整个方案里最棘手的几个技术难点和对应的解法梳理成一张表,你会怎么列?
候选人🙋:
我梳理了五个关键难点和解决方案,可以做一个简洁的对照表:
技术难点
解决方案
一句话亮剑
1. 大文件网络抖动导致全量重传
分片上传 + 断点续传。每个分片独立传输,失败只重传该片;通过文件哈希和 Redis 记录已传分片,刷新页面可从断点继续。
化整为零,断而能续
2. 浏览器内存/主线程被哈希计算卡死
使用 Web Worker 在后台线程计算文件 SHA-256,计算完成通过 postMessage 通知主线程。
哈希不卡UI,体验不掉线
3. 业务服务器带宽被打满,影响正常请求
客户端直传对象存储(OSS/S3),业务服务器只签发预签名 URL,不搬运文件流。
流量绕行,主链路零负担
4. 重复文件反复上传浪费资源
秒传机制:上传前通过文件哈希查询对象存储是否已存在,存在则直接返回访问链接。
一传永逸,重复秒得
5. 多分片并发导致浏览器连接数耗尽或拥塞
Promise 并发池控制,限制同时进行的分片上传数量(如6个),配合 HTTP/2 多路复用优化。
手控阀门,速稳兼得
6. 上传中断产生的碎片浪费存储成本
定时任务扫描 Redis 中过期的 uploadId,调用 OSS 的 AbortMultipartUpload 清理未合并的分片。
断舍离,成本不走空
面试官👨💼:
非常好,方案从原理到代码、从亮点到坑点都覆盖到了,而且能看出你有真实的大文件上传落地经验。今天的考察就到这儿,你表现很扎实👍。
💡 关键得分点复盘(给读者的悄悄话)
- ✅ 分片 + 断点续传 + 秒传 → 用户体验基石
- ✅ 直传 OSS 预签名 → 带宽和并发解的银弹
- ✅ Web Worker 算哈希 + Promise 并发池 → 前端工程化亮点
- ✅ Redis 状态管理 + 预签名按需签发 → 后端架构闭环
- ✅ 技术难点表格 → 展示你系统性解决问题的思维
如果本文对你有帮助,欢迎关注我的公众号【Rain的Java大神之路】。
专注 Java 面试、源码、高并发实战,回复“Java”领取《大厂面试手册》,持续更新。
"原文地址: https://www.cveoy.top/t/topic/qHAH 著作权归作者所有。请勿转载和采集!